엔터프라이즈 LLM 서비스 구축기 2: 에이전트 엔지니어링
Summary
96% 응답률의 비결, 화려한 기술보다 '단순함'을 선택한 FAA의 전략
파인 튜닝과 복잡한 워크플로를 걷어내고 엔터프라이즈 LLM의 본질에 집중하는 법
수백 개의 기술 문서를 다루는 엔터프라이즈 환경에서 LLM 에이전트가 나아가야 할 실전 방향을 제시합니다. 무분별한 최신 기술 도입 대신, 서비스의 본질인 '정확한 정보 전달'을 위해 RAG와 ReAct라는 기본기에 집중하여 얻은 성과와 구체적인 의사 결정 과정을 공유합니다.
- 01지식 주입에 비효율적인 파인 튜닝 대신 '오픈북' 방식인 RAG 전격 채택
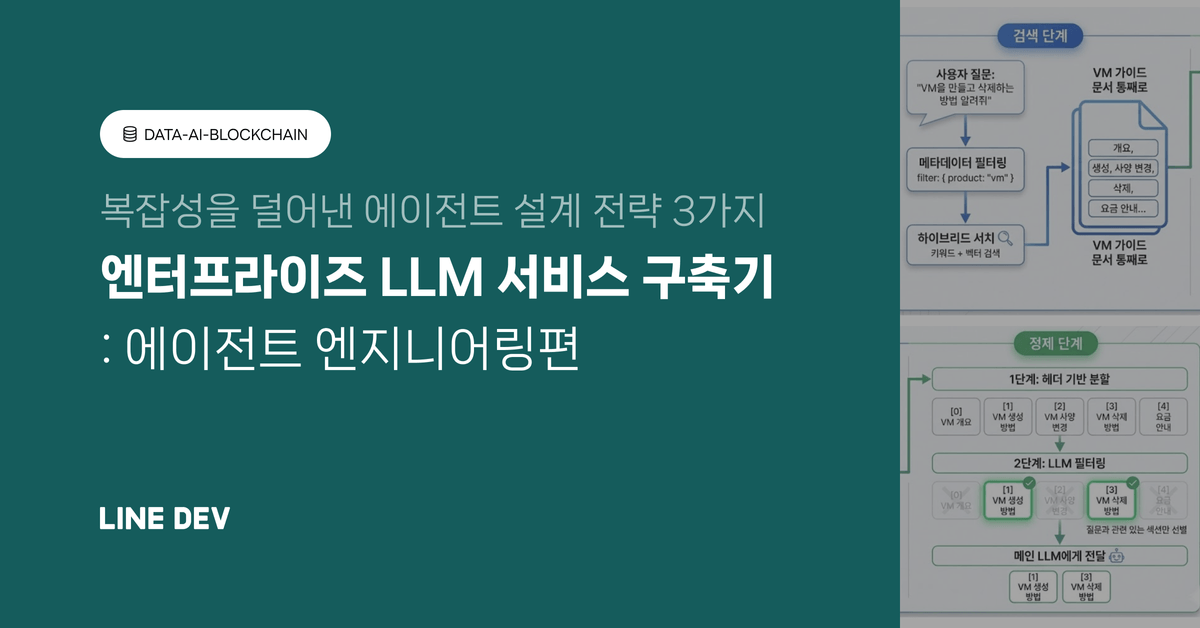
- 02문맥 파괴를 막는 혁신적 역발상: 청킹하지 않고 통째로 검색하는 'Post-split' 전략
- 03복잡한 '계획 후 실행' 구조를 버리고 단순한 ReAct 루프로 답변 품질과 속도 확보
- 04경량 LLM 필터를 활용해 추가 비용 부담 없이 검색 정밀도 극대화
- 05미답변의 50%가 기술 오류가 아닌 '문서 부재'임을 확인하며 시스템 신뢰성 검증
RECOMMENDATION
최신 LLM 트렌드에 매몰되어 시스템 복잡도만 높이고 있는 엔지니어들에게 권장합니다. 특히 RAG의 고질적인 문제인 문맥 손실을 해결하고 싶은 팀이라면 본문의 '검색 후 자르기' 전략을 즉시 검토해 보시기 바랍니다.
The Problem
엔터프라이즈 환경에서 수백 개의 도구와 문서를 다루는 LLM 에이전트 구축 시, 최신 지식의 정확한 전달과 복잡한 워크플로 관리의 효율성 문제가 발생합니다. 특히 파인 튜닝은 지식 주입 효율이 낮고 유지보수가 어려우며, 기존 RAG의 청킹 방식은 문맥 손실을 초래하여 답변 품질을 저하시키는 한계가 있었습니다.
The Solution
지식 주입을 위해 파인 튜닝 대신 RAG를 채택하고, 문맥 보존을 위해 사전 청킹 없이 문서를 통째로 임베딩한 후 질문에 맞춰 필요한 부분만 LLM으로 필터링하는 '검색 후 자르기(Post-split)' 전략을 도입했습니다. 또한 복잡한 계획 수립 단계 대신 단순한 ReAct(Reasoning and Acting) 루프를 활용하여 에이전트가 스스로 추론과 도구 호출을 반복하며 답을 찾도록 설계했습니다.
The Result
FAA 릴리스 후 관련 문의의 약 96.1%에 대해 실질적인 답변을 제공하는 성과를 거두었으며, 분석 결과 미답변 사례의 약 50%가 시스템 결함이 아닌 원본 문서 부재로 확인되어 아키텍처의 견고함을 입증했습니다. 이는 기술적 복잡도를 낮추면서도 서비스 본질인 정보 전달 정확도를 극대화한 결과입니다.
Trade-off
멀티 에이전트 구조를 포기함에 따라 특정 도메인에 특화된 심층 추론 능력은 단일 에이전트의 LLM 성능에 의존하게 되며, 검색 후 자르기 과정에서 LLM을 추가 호출함으로써 미세한 지연 시간이 발생할 수 있습니다. 하지만 이는 출력 토큰을 최소화하는 경량 모델 필터링을 통해 비용과 속도 측면에서 합리적으로 절충되었습니다.
Key Concepts
 More from 라인
View all posts from 라인
Flava MCP Hub가 걸어온 길: AI 시대를 위한 배관 공사
Model Context ProtocolAPI GatewayOIDC4일 전
AI로 E2E 회귀 테스트 자동화하기: ‘딸깍’을 파이프라인으로 바꾸기까지
AI Test AutomationE2E TestingPlaywright2주 전
LLM이 만든 SQL을 믿고 실행하기까지: A2A 기반의 대화형 BI 애플리케이션 개발기
LLMRAGMulti-Agent4주 전
LLM에게 어디까지 맡길 것인가: AI 에이전트 기반 광고 분석 리포트 자동화
LLMAI AgentReAct1개월 전
AI를 전제로 다시 설계하다, Tech-Verse 2026 참관기
AI AgentMCPDevOps1개월 전