모델만 바꿨는데 LLM 비용이 3배가 된 이유
Summary
단가 20% 싼 LLM으로 바꿨는데 비용이 3.2배 폭등한 원인과 해결책
OpenAI·Anthropic·Gemini 프롬프트 캐시 동작 원리 및 명시적 구분점 활용 비용 절감 가이드
LLM 단가를 낮추기 위해 모델을 교체했다가 예상치 못한 비용 폭등을 겪은 당근 커뮤니티팀의 실무 해결 복기글입니다. 주요 LLM 제공사(OpenAI, Anthropic, Gemini)의 프롬프트 캐싱 및 KV 캐시 동작 방식의 차이를 정밀하게 비교 분석합니다. 고정 프롬프트와 동적 입력 경계에 명시적 구분점을 설정해 히트율을 95%까지 끌어올리고 비용을 5분의 1로 절감한 실전 아키텍처 노하우를 제공합니다.
- 01Gemini에서 GPT-5.6 교체 후 캐시 히트율 급락(85.8% -> 2.3%)으로 인한 3.2배 비용 증가 원인 규명
- 02제공사별 자동 캐시 구분점 위치 및 쓰기 할증(Write Surcharge) 요금 체계 비교 분석
- 03고정 지시문 경계에 명시적 구분점(prompt_cache_breakpoint)을 설정해 비용 80% 감축
- 04타임스탬프, UUID, JSON 키 순서 변경 등 캐시를 깨뜨리는 주요 요소 정리
- 05운영 트래픽 기반 캐시 히트율 모니터링 및 프롬프트 템플릿의 시스템적 관리 필요성 제시
RECOMMENDATION
대량의 고정 지시문이나 대화 이력을 LLM API로 지속 전송하는 백엔드 엔지니어 및 AI 개발자에게 적극 추천합니다. 모델 교체 시 단순 토큰 단가표 외에 제공사별 캐시 구분점 동작 및 쓰기 할증 정책을 반드시 검증해야 합니다.
The Problem
당근 커뮤니티홈팀은 주제 분류 작업의 LLM 단가를 낮추기 위해 Gemini에서 단가가 20% 저렴한 OpenAI GPT-5.6으로 모델을 변경했으나, 에러 없이 요청당 비용이 오히려 3.2배로 급증했습니다.
The Solution
모델 변경 후 캐시 히트율이 85.8%에서 2.3%로 급감한 원인을 분석하여, 자동 구분점의 위치 변화로 인해 고정 지시문 캐시가 깨짐을 확인하고 프롬프트 고정부 끝에 명시적 구분점(prompt_cache_breakpoint)을 추가했습니다.
The Result
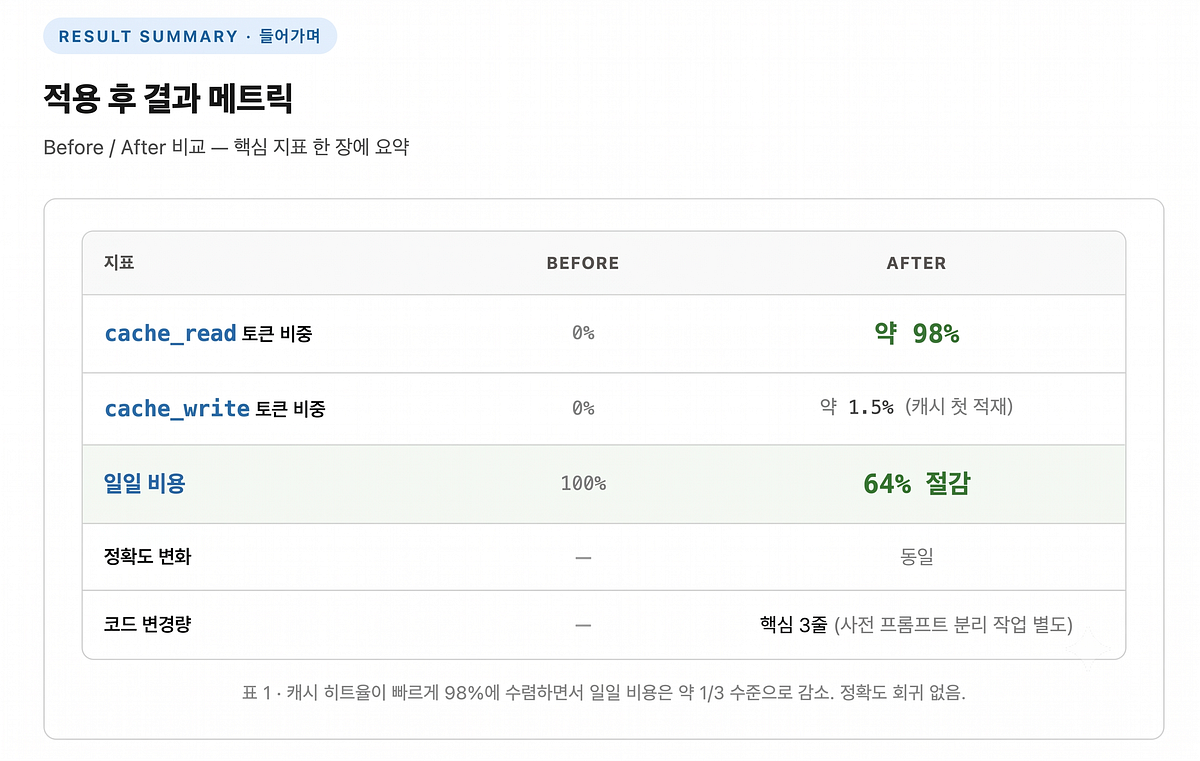
명시적 구분점 적용 후 캐시 히트율이 95% 안팎으로 상승하였으며, 주제 분류 작업의 요청당 비용을 기존 대비 약 5분의 1 수준으로 크게 절감했습니다.
Trade-off
캐시 저장 시 쓰기 할증(Write Surcharge) 비용이 발생하는 모델의 경우, 캐시 히트율이 약 22% 미만으로 떨어지면 캐시를 아예 쓰지 않을 때보다 전체 비용이 더 비싸질 수 있습니다.
Key Concepts
 More from 당근
View all posts from 당근Aurora MySQL 인덱스 DDL이 Reader 버퍼풀을 비운다?
Aurora MySQLDatabase IndexBuffer Pool3주 전당근 동네걷기 위에서 동시에 쏟아지는 오버레이들을 우아하게 제어하기
ReactPromiseWebview4주 전당근의 인증은 어떻게 달라져 왔을까요?
OAuth 2.0OIDCSSO2개월 전Laying the Rails Beyond WebView: Why Karrot Chose Lynx
LynxWebViewPerformance2개월 전웹뷰 다음의 레일을 깔다: 당근이 Lynx를 선택한 이유
LynxReactQuickJS2개월 전